주간 연구 브리핑 — AI·신약·기능성식품 (2026-09-20)
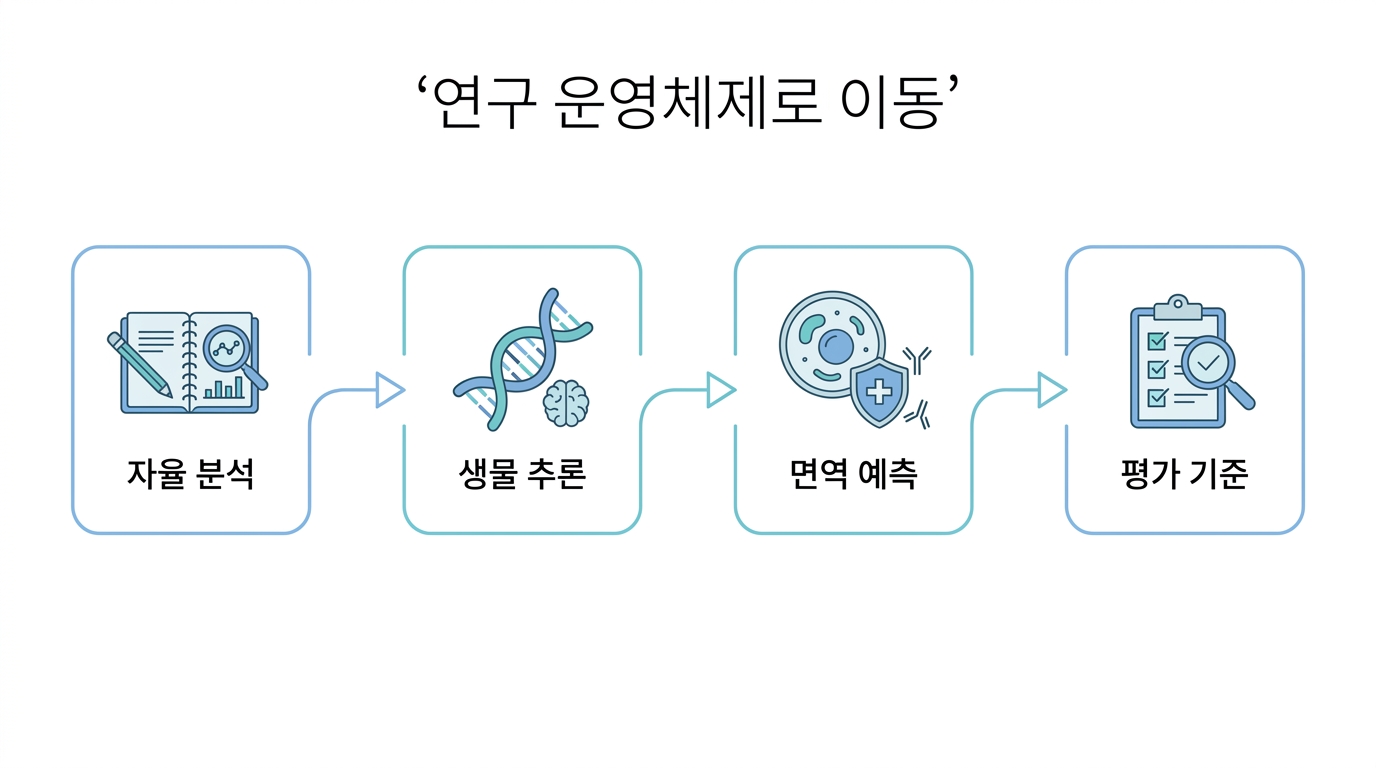
이번 주 자료를 모아 놓고 보니 공통점이 하나 있었습니다. 더 정확한 예측 모델을 만들었다는 이야기가 아니라, 분석을 누가 설계하고 결과를 무엇으로 판정할 것인가를 다루고 있었습니다.
연구 질문을 만드는 단계, 생물학적으로 추론하는 단계, 임상으로 넘어갈 수 있는지 판정하는 단계가 각각 따로 손보던 영역이었는데, 이번 주 자료들은 그 세 단계를 하나의 작업 흐름으로 묶으려 하고 있습니다. 우리 연구실 입장에서 중요한 건 모델 성능 숫자가 아니라, 그 흐름 안에서 무엇을 검증 항목으로 남겨야 하는가입니다.
신약·바이오 신기술
단일세포 데이터 분석을 자율 에이전트가 수행하는 CellVoyager가 Nature Methods에 실렸습니다. 배경 정보만 주면 분석 후보를 만들고, 그것을 실행 가능한 노트북 절차로 구현합니다. 출판된 scRNA-seq 연구 76건을 모은 벤치마크에서, 원저자들이 실제로 수행했던 분석을 예측하는 능력이 일반 모델 대비 최대 23% 앞섰다고 보고합니다.
다만 여기서 검증된 것은 계산 분석과 전문가 평가까지이고, wet-lab 검증은 아닙니다. 분석 품질도 데이터 전처리와 도구 선택에 그대로 의존합니다.
So what → 연구실 연결: 발효·노화·면역 단일세포 공개 데이터셋을 학생 과제로 재분석하는 강의형 워크플로로 거의 그대로 옮길 수 있습니다.
타겟·소재
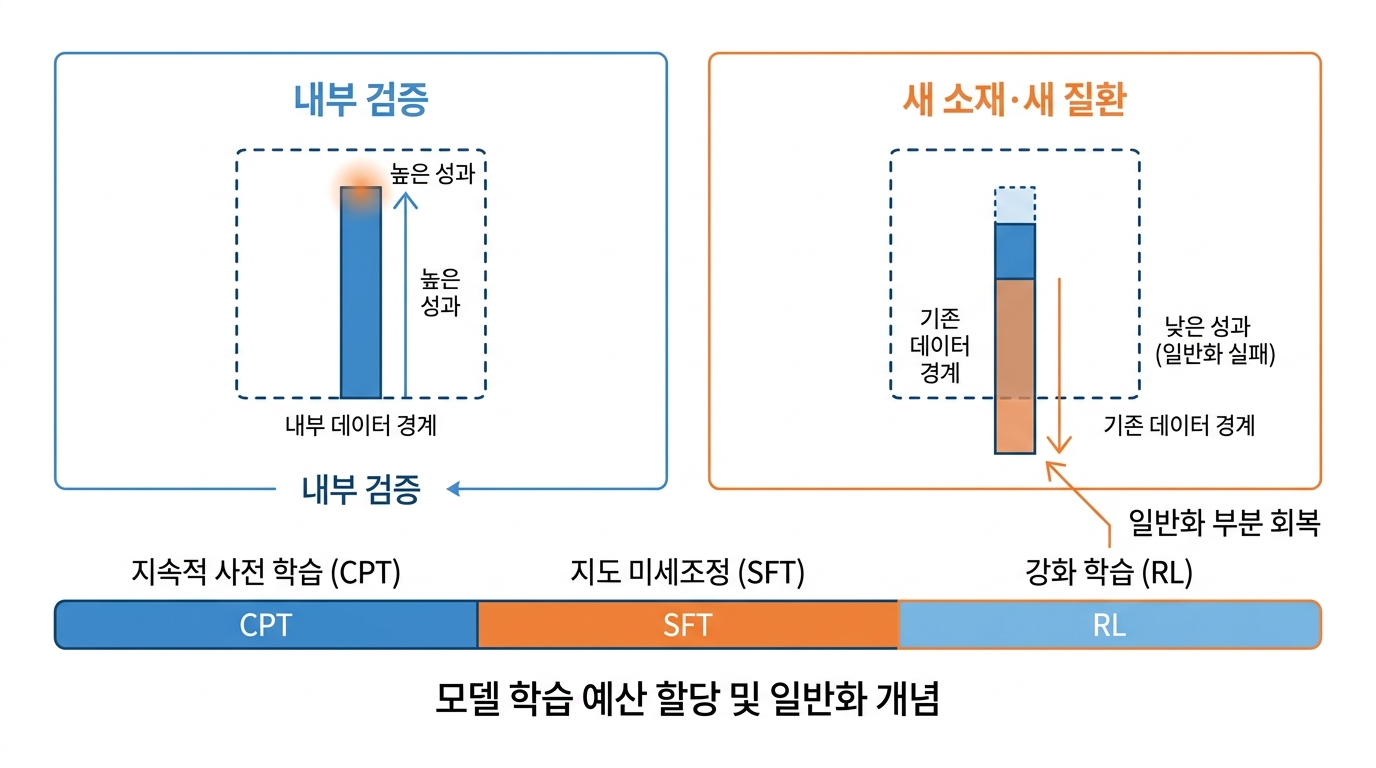
생물학 추론 모델의 post-training을 다룬 프리프린트가 흥미로웠습니다. 100개 이상의 모델을 놓고 비교했더니, 지도학습(SFT)을 키우면 내부 검증 성능은 올라가지만 처음 보는 영역에서의 일반화는 오히려 좁아졌습니다. 강화학습(RL)을 붙였을 때 그 일반화가 부분적으로 회복됐습니다.
즉 학습 단계를 "성능 향상" 한 덩어리로 보면 안 되고, 어디에 예산을 배분할 것인가의 문제로 봐야 한다는 이야기입니다. 특정 백본과 벤치마크 중심의 프리프린트라는 점은 감안해야 합니다.
So what → 연구실 연결: 우리가 기능성 예측 모델을 만든다면, 내부 검증 정확도를 올리기 전에 held-out 소재·질환·종 기준의 분할부터 설계해야 합니다. 이건 모델 이야기가 아니라 실험 설계 이야기입니다.
식품·기능성 직결
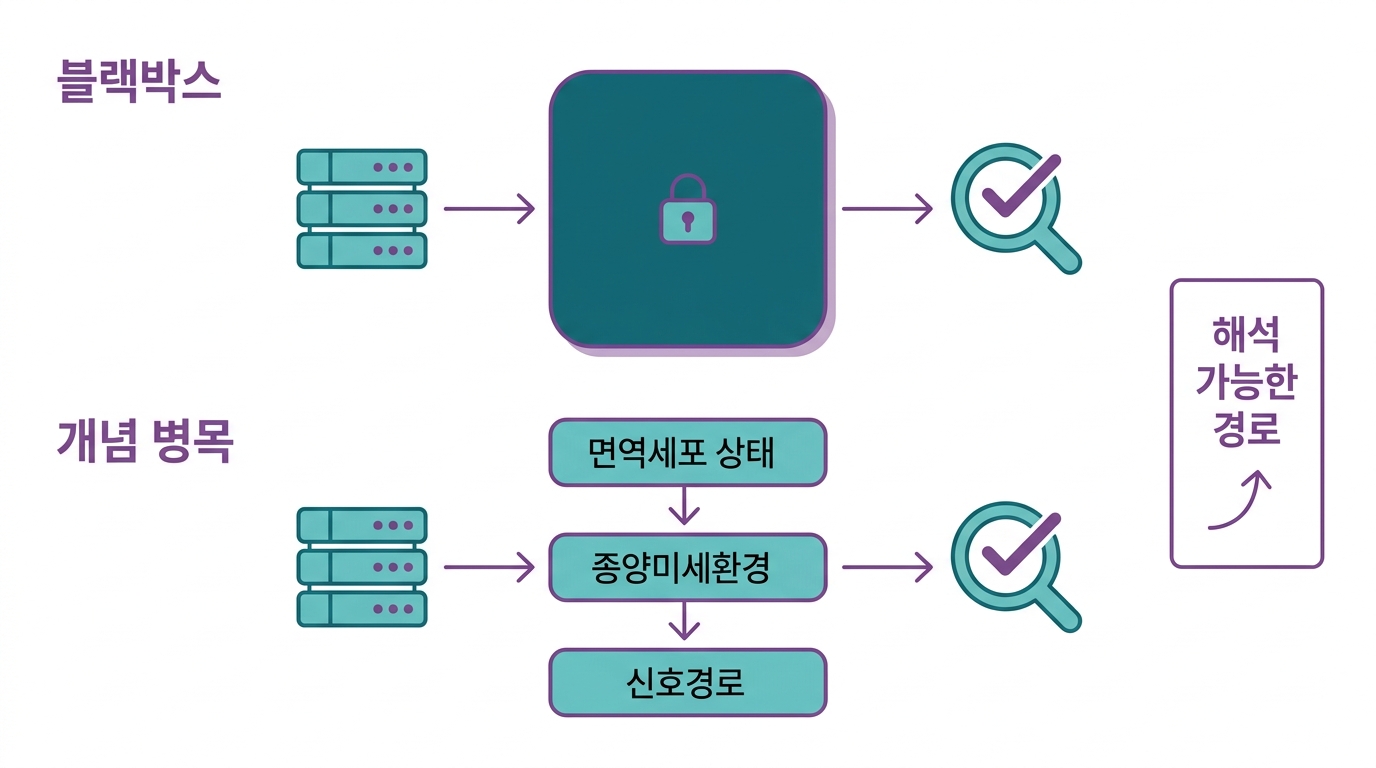
COMPASS는 bulk 종양 전사체에서 면역 관련 개념 44개를 거쳐 면역관문억제제 반응과 생존 차이를 예측하는 모델로, Nature Medicine에 실렸습니다. 33개 암종 1만여 종양으로 학습하고 16개 임상 코호트에서 검증했습니다. 평균 정확도 8.5%, AUPRC 15.7% 개선을 보고합니다.
눈여겨본 건 성능보다 구조입니다. 예측을 블랙박스로 두지 않고 면역세포 상태·종양미세환경·신호경로라는 개념 단위로 분해했습니다. 해석과 전이를 동시에 노린 설계입니다. 물론 아직 전향적 임상 의사결정 도구는 아니고, assay 표준화와 재현 가능한 inference 파이프라인이 전제되어야 합니다.
So what → 연구실 연결: 천연물·발효소재의 면역 조절 효과도 단일 마커 하나로 주장하기보다, 개념 병목형 pathway 패널로 가설을 구성하는 편이 방어 가능합니다. 44개 개념 목록은 그대로 우리 강의용 어휘집이 될 수 있습니다.
Frontier
자율 연구 시스템 4종이 만든 논문 60편을 동일 루브릭(originality·rigor·clarity·significance)으로 비교한 프리프린트가 나왔습니다. 결과는 겸손합니다. 가장 나은 기준 시스템도 5점 만점에 2.14~2.47이었고, 나머지는 1.00~1.87이었습니다.
결론이 "아직 멀었다"는 것만은 아닙니다. 진짜 병목이 생성이 아니라 평가 프로토콜이라는 점을 드러낸 게 핵심입니다. 평가를 LLM이 했다는 점에서 편향 문제도 남아 있습니다.
So what → 연구실 연결: 학생 AI 과제를 받을 때 결과물만 받으면 안 됩니다. 평가 루브릭, 재현 로그, 실패한 이유를 함께 내게 해야 배우는 게 남습니다.
이번 주 실행 결정
Kill — 내부 검증 정확도만 높인 기능성 예측 모델을 성과로 보고하는 방향. 이번 주 자료가 그게 왜 위험한지 보여줬습니다.
Watch — 자율 연구 시스템의 평가 루브릭 논의. 시스템 자체보다 평가 기준이 먼저 정리될 영역입니다.
Test — 학생 1명, 30분. CellVoyager GitHub 예제와 COVID-19 케이스를 열어 CellBench의 입력·출력 형식이 무엇인지, 그리고 논문이 제시한 실패 사례 2개가 어떤 것인지 확인합니다. 재현 로그가 돌지 않으면 COMPASS 보충표의 44개 면역 개념을 우리 pathway 어휘집으로 매핑하는 쪽으로 전환합니다.
Write — 기능성 소재 예측 과제의 데이터 분할 원칙을 한 페이지로 정리합니다. held-out 소재·질환·종을 어떻게 나눌지, 그 기준을 먼저 문서로 남겨야 나중에 방어가 됩니다.
출처: Nature Methods (2026), Nature Medicine (2026), arXiv:2606.16517, arXiv:2607.28631. 프리프린트는 동료평가를 거치지 않은 자료이며, 계산 분석 결과는 wet-lab 검증과 구분해 읽어야 합니다.
댓글 0
첫 한 줄을 남겨 보자.
로그인 뒤 한 줄을 남길 수 있다.