주간 연구 브리핑 — AI·신약·기능성식품 (2026-10-29)
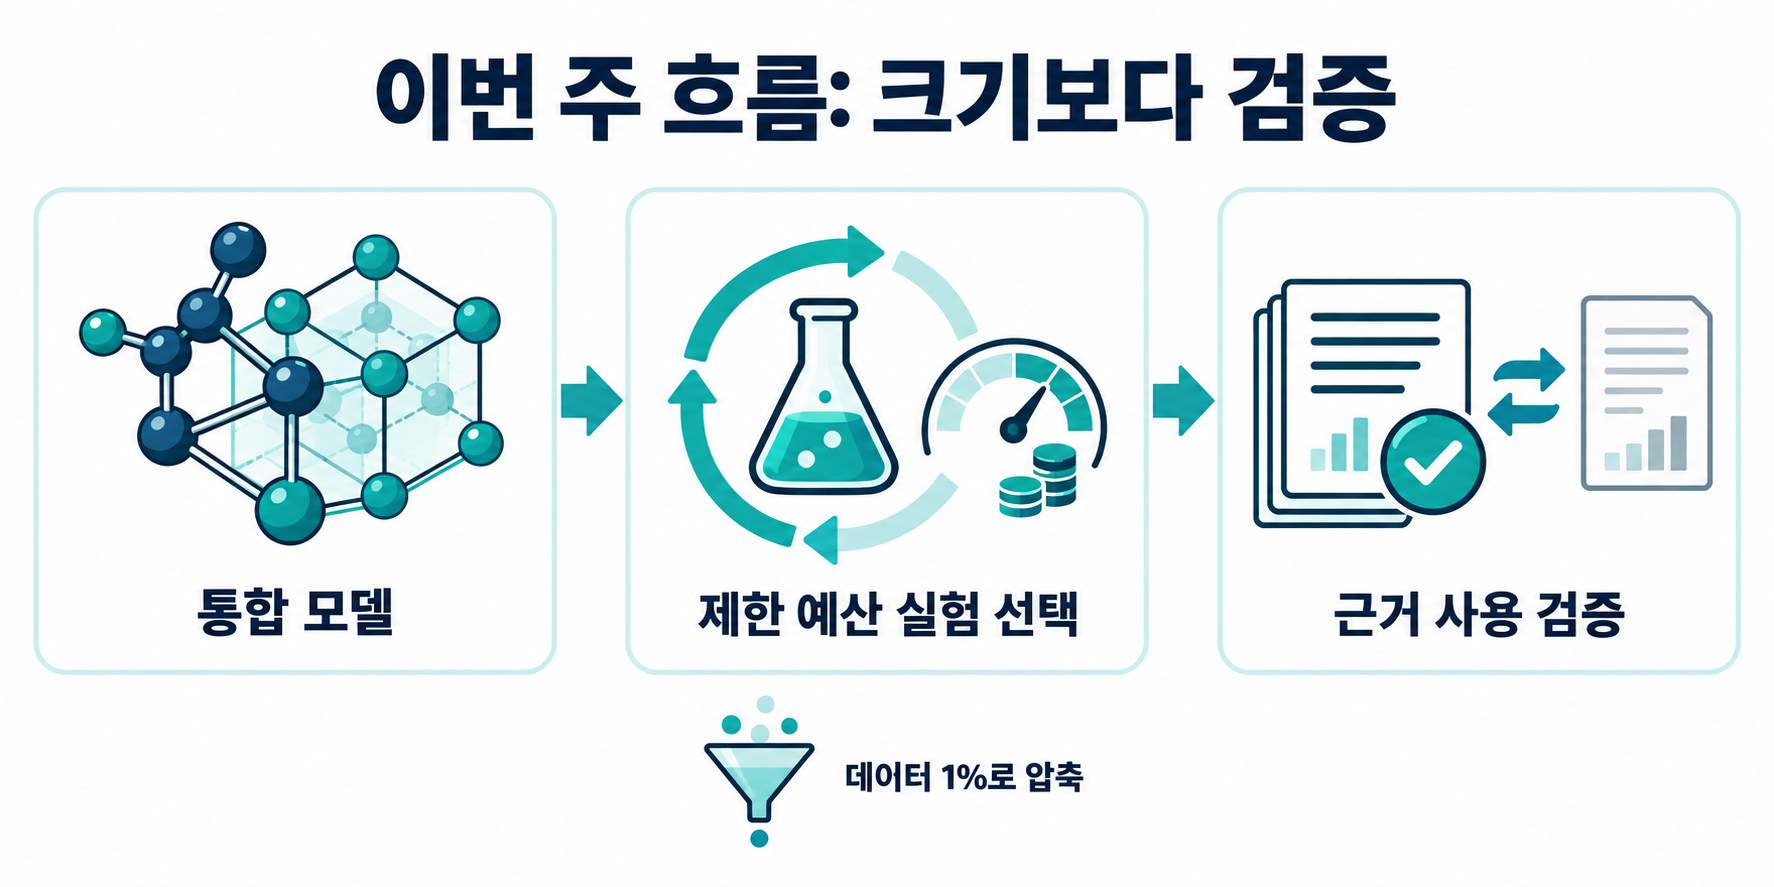
대상 기간은 2026-10-19(월)부터 10-24(토)까지다. 이번 주 과학 AI 논문들은 모델을 얼마나 크게 만들었는지보다 얼마나 정직하게 검증했는지를 다퉜다. 제한된 실험 예산 안에서 다음 실험을 고를 수 있는지, 넣어 준 근거를 실제로 판단에 쓰는지, 데이터의 대부분이 중복은 아닌지를 각각 따로 재는 평가틀이 한꺼번에 나왔다.
신약·바이오 신기술
분산 에이전트 해석: Scripps·OpenAI·HHMI 연구진은 전뇌 in vivo Perturb-seq 지도의 섭동 1,946개에 에이전트를 하나씩 붙이고, 그 보고서를 합쳐 연구 전체의 해석을 32분 만에 냈다고 보고했다. DEG를 근거로 한 원논문 결론 55개 중 48개(87.3%)를 되찾았고, 섭동 ID를 섞자 'agree' 비율이 29.3%에서 13.2%로 떨어져 우연이 아니라는 점도 확인했다. 다만 모델의 사전학습 데이터에 원논문 내용이 섞였을 가능성은 남아 있고, 효과가 작은 섭동에서는 검증이 제한적이다(bioRxiv, 2026.10.15.759436).
Madrigal(Harvard Zitnik Lab): 구조·경로·세포생존·전사체 네 모달리티를 통합해 약물 조합의 임상 결과를 예측한다. 임상 결과 953종과 화합물 21,842개를 다뤘고, 일부 모달리티가 비어 있는 화합물도 처리한다. 다만 임상 수준 검증은 AML xenograft로 한정되며, 전사체 데이터가 없는 신규 화합물에서는 예측력이 떨어질 수 있다(arXiv:2503.02781).
So what → 연구실 연결: 발효·천연물 스크리닝을 처리군 단위로 쪼개 해석하는 구조는 그대로 가져다 쓸 만하다. 식품 성분과 약물의 상호작용 사전 스크리닝은 아직 예측 단계라 wet-lab 확인이 필수다.
타겟·소재
Zatom-1은 분자와 결정의 생성·물성 예측을 3D 모델 하나(최대 3억 파라미터)로 묶었다. 재료 데이터를 함께 사전학습하자 분자 물성 예측도 좋아졌다. 반면 단일 과제에 최적화한 모델보다 떨어지는 물성 항목이 있다(arXiv:2602.22251).
Atoms that Matter는 OMat24에서 국소 화학환경을 토큰화하고 set-cover로 골라낸 1% 미만의 subset(약 79.6만 구조)만으로, 전체 데이터로 학습한 MACE에 가까운 성능을 냈다. 하지만 비정상·비벌크 구조에서는 오차가 커지므로 "데이터의 99%가 쓸모없다"는 뜻으로 읽으면 안 된다(arXiv:2610.14392).
So what → 연구실 연결: 시료를 더 모으기 전에 LC-MS 시료를 화합물 class·adduct·RT bin으로 토큰화해 중복을 걸러내는 데이터 설계를 시험해 볼 수 있다.
식품 이식 기술 — 자율실험과 근거 검증
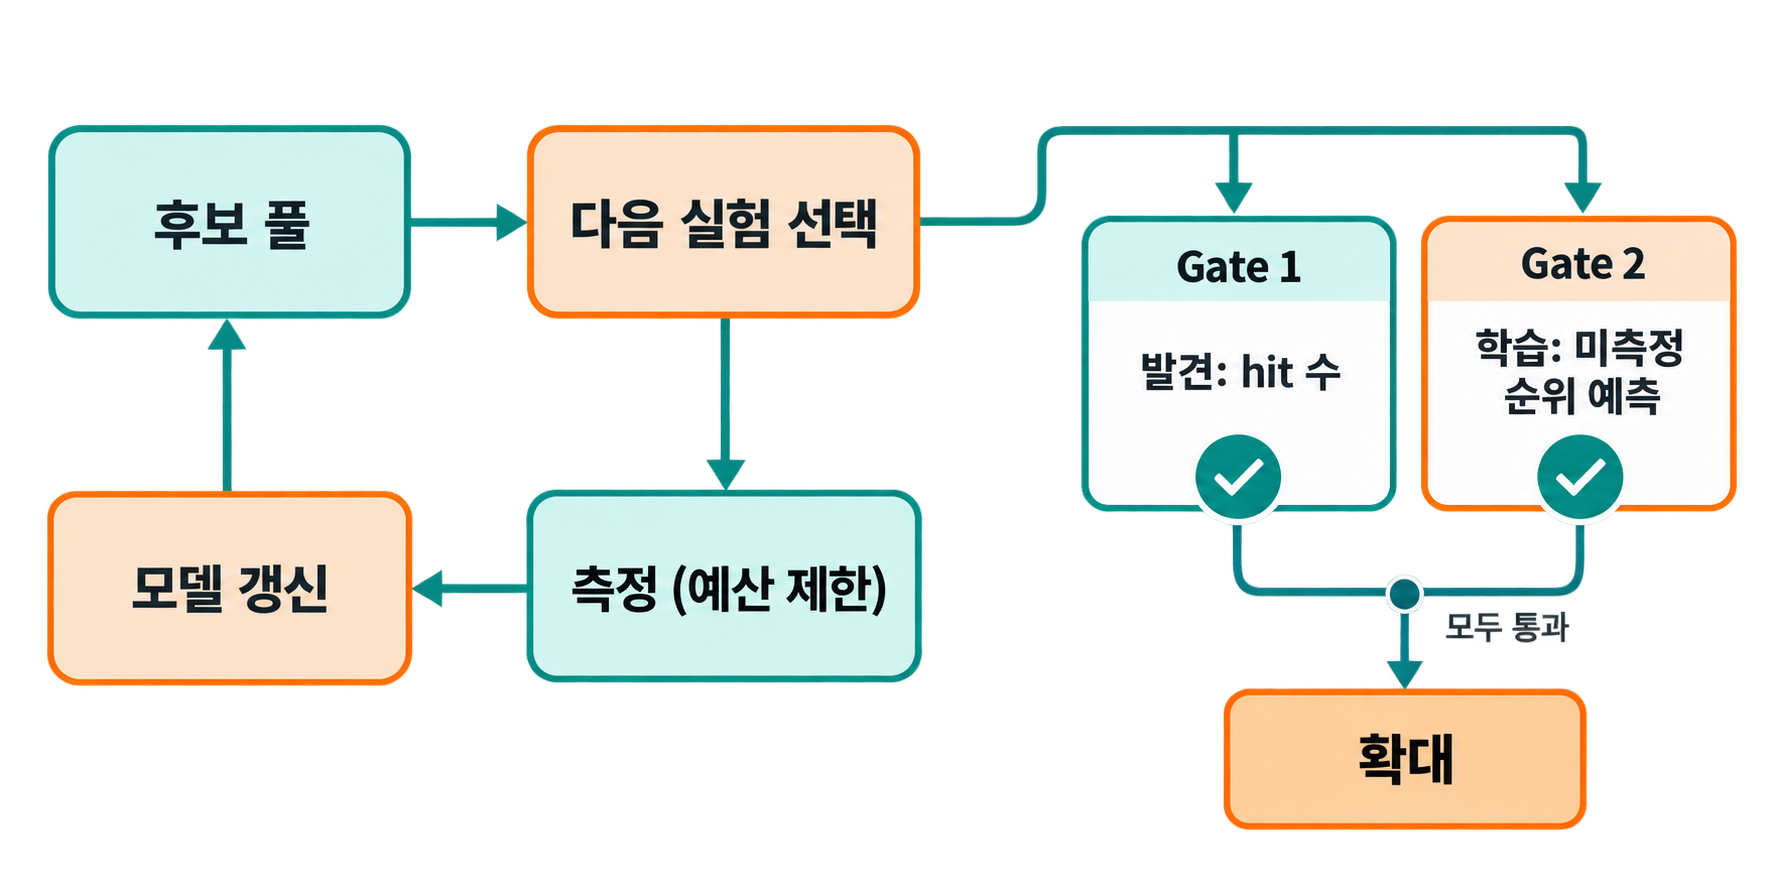
Autonomous Science Bench는 생물·화학·재료 6개 캠페인에서 에이전트가 정해진 예산(후보 풀의 1.9~10.6%) 안에서 다음 실험을 고르게 한다. 그리고 발견(hit 수)과 학습(측정하지 않은 설계의 순위 예측)을 별도 gate로 평가한다. 총 144회 시행에서 가장 좋은 구성도 성공률이 67%였고, 가장 어려운 캠페인은 24회 중 3회만 풀렸다. 6개 중 5개 캠페인은 기록을 재생한 것이고 1개는 digital twin이라, 실제 로봇 실험실에서 통한다는 증거는 아니다(arXiv:2610.18449).
LabOPBench에서는 실험 이미지와 절차 문맥을 함께 넣어도 최신 멀티모달 모델들의 정규화 점수가 28.8~45.8%에 그쳤다. 주된 오류는 증거를 잘못 읽거나, 읽은 증거와 내린 결정이 어긋나는 경우였다(arXiv:2610.19780). CompMat-Bench는 계산재료 workflow가 길어지고 지침이 줄어들수록 에이전트별로 성능이 다르게 무너진다는 점을 보였다(arXiv:2610.00636).
CellChain은 18개 foundation model을 대상으로 근거를 단계별로 넣었다 뺐다 해 보았다. 근거를 늘린다고 정확도가 꾸준히 오르지는 않았고, 약물감수성 과제에서는 맞는 이력이 바꿔치기한 이력보다 평균 13.0%p 높았다. 정답을 고르는 benchmark이므로 인과관계를 입증한 결과는 아니다(arXiv:2610.16346).
So what → 연구실 연결: 발효·추출 조건 최적화를 '제한된 예산 안에서 다음 시료 고르기 + 측정하지 않은 조건 예측'이라는 이중 gate 과제로 다시 설계할 수 있다. 오믹스로 후보를 설명할 때는 맞는 근거와 무관한 근거를 각각 넣어 보는 대조 QA를 표준 절차로 삼는다.
규제·사업화
Virtual Biology Initiative: Biohub·DOE·NIH·Google DeepMind·Isomorphic Labs·Meta 등이 약 18억 달러 규모로 가상세포용 공개 데이터를 만들겠다고 발표했다(10-07 파트너 확장). 아직 발표 단계라 전액 집행이 확정되지 않았고, 성능 지표와 일정도 공개되지 않았다.
So what → 연구실 연결: 데이터 표준이 공개되면 세포 수준 천연물 처리 데이터를 그 표준에 맞출 수 있는지 점검한다.
이번 주 실행 결정
- Test — Autonomous Science Bench의 biosensor 공개 캠페인을 random 선택과 uncertainty sampling으로 각 1회 실행해 hit 수와 NDCG@20을 기록한다(학생 1명). 30분 사전 단계로는 Table 2와 gate 정의를 한 장으로 정리한다. 두 방법 모두 기준선(discovery 21 hits 또는 NDCG@20 0.70)을 넘지 못하면 에이전트 도입은 중단하고 평가 설계만 재사용한다.
- Test — 후보물질 1건에 맞는 근거와 무관한 근거를 각각 붙여 같은 질문을 던지고, 결론·인용·확신도의 변화를 표로 비교한다(학생 1명·30분, CellChain 방식).
- Write — 발효조건 최적화를 '발견/학습 이중 gate' 과제로 정리한 축소판 계획서를 쓴다. 위 Test를 통과한 경우에만 진행한다.
- Watch — Virtual Biology Initiative 데이터 표준, Madrigal의 식품-약물 상호작용 적용 가능성.
- Kill — "데이터·근거를 많이 넣을수록 좋아진다"는 전제로 모델 규모를 늘리는 계획.
댓글 0
첫 한 줄을 남겨 보자.
로그인 뒤 한 줄을 남길 수 있다.